楽譜と歌詞を入力すると歌声が出力される「歌声合成」は、深層学習の発展によって飛躍的に進歩しました。しかし、最先端のモデルは大量の歌唱データと大きな計算資源を必要とします。一人の歌い手のデータが数十曲しかない、高性能な計算機を長時間使えない、といった小さな環境では、なかなか手が届きません。
一方で、少ないデータと限られた計算資源でも動く軽量なモデルもあります。その一つが、日本語の歌唱に適したオープンソースの歌声合成システム NNSVS です。ただし軽量なぶん、音の高さや音色の予測に誤差が積み重なりやすく、ビブラートのような細かな揺れも再現しにくいため、どうしても機械的な歌声になりがちです。
私たちは、この軽量なモデルの手軽さを保ったまま、歌声をより自然にする方法を研究しています。
予測結果を出発点にして、少しずつ直す
高品質な生成 AI としてよく使われる拡散モデルは、ランダムなノイズから出発して、数十から数百回の計算を繰り返してデータを作ります。品質は高いものの、時間がかかります。これに対して Rectified Flow という手法は、出発点から目的のデータまでをまっすぐな経路で結ぶように学習することで、5〜10 回程度の少ない計算でも高品質な生成ができます。
私たちはこの考え方を「補正」に応用しました。ランダムなノイズから出発するのではなく、NNSVS の予測結果を出発点にして、本物の歌声に向かう修正の方向を学習します(図1)。NNSVS の予測はすでに本物にある程度近いので、補正ネットワークが学ぶのは残った「ずれ」だけで済みます。そのため補正ネットワークは小さなもので済み、少ない回数の計算で補正できます。
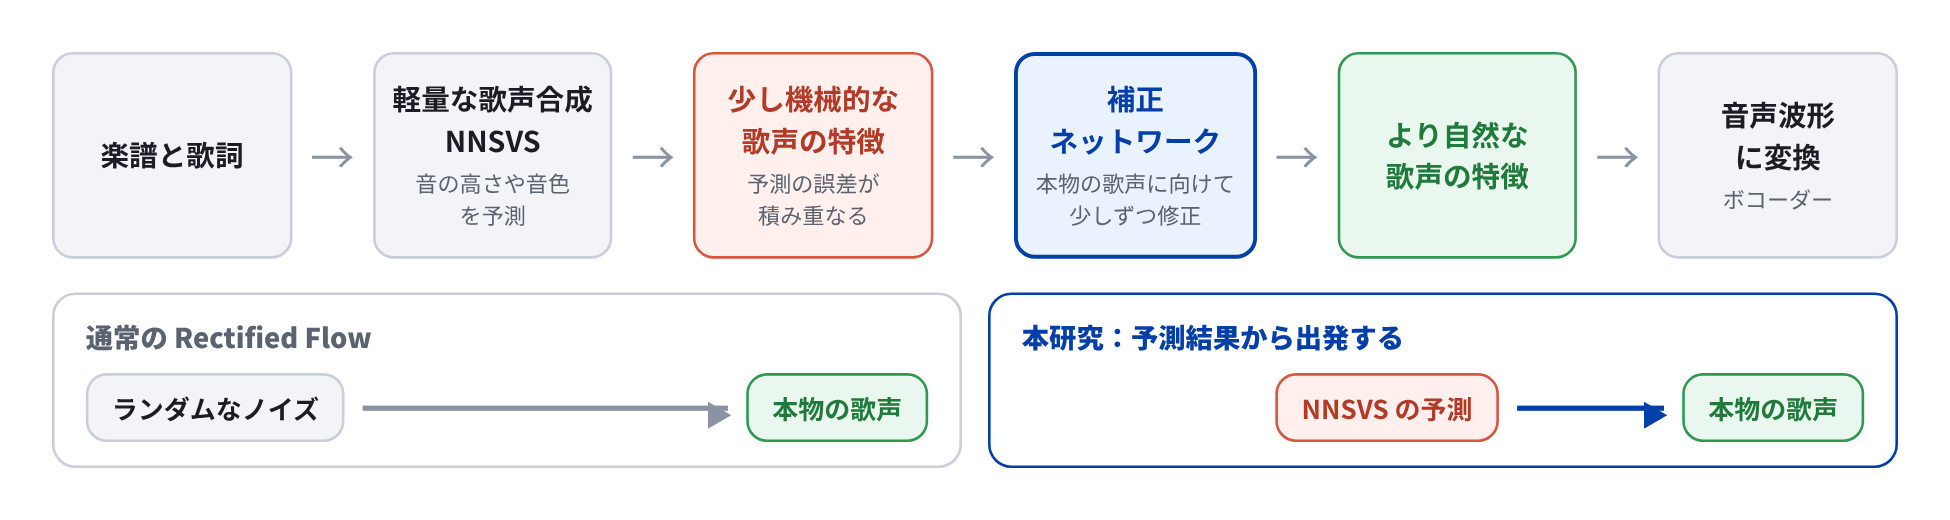
図1:提案手法の流れ(上)と、通常の Rectified Flow との違い(下)
聴いて確かめる
実験には、女性歌唱者 1 名による 50 曲の日本語歌唱を収録したオープンソースの「東北きりたん歌唱データベース」を使いました。41 曲を学習に、6 曲を検証に、3 曲をテストに用いています。
まず、音の特徴量の予測誤差は、補正によって全体で 44% 小さくなりました。とくに音色、声の有無、息や摩擦音に関する成分で一貫して誤差が減っています。
次に、実際に人が聴いてどう感じるかを確かめました。20 名の方に、歌声の自然さを 5 段階で評価してもらった結果が図2 です。
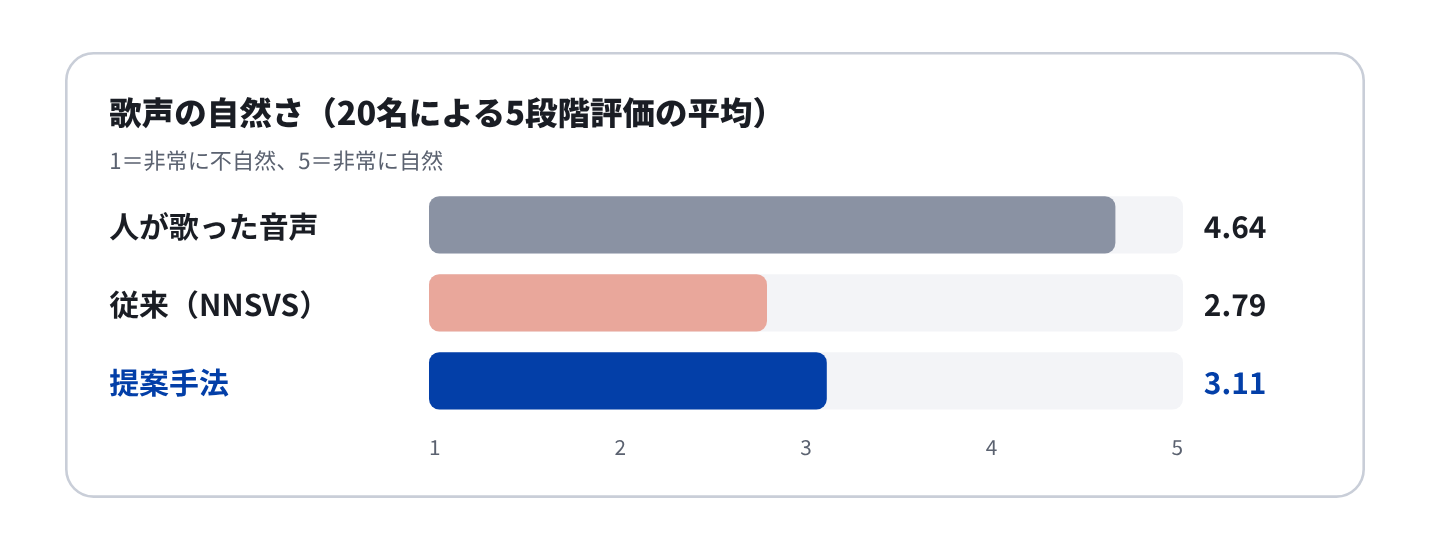
図2:歌声の自然さの主観評価(MOS)
提案手法の評価は 3.11 で、従来の NNSVS の 2.79 から 0.32 向上しました。この差は統計的に有意でした(p < 0.001)。歌声の品質を自動で推定する指標(SingMOS)や、本物の歌声との分布の近さを測る指標(FAD)でも、同じく改善が確認されています。
残っている課題
一方で、音色のずれを測る指標(MCD)と音の高さの誤りを測る指標(FFE)は、わずかに悪化しました。特徴量の段階では誤差が減っているのに、最終的な音声では一部の指標が改善しなかったことになります。これは、特徴量を音声波形に変換する段階(ボコーダー)で、補正の効果が十分に伝わらなかったためと考えています。実際、音声波形にしたあとで測り直した誤差は、特徴量の段階の約 4 倍になっていました。
また、人が歌った音声の評価は 4.64 であり、本物の歌声との間にはまだ大きな差があります。今後は、音声波形に変換する過程も含めて改善することで、さらに自然な歌声を目指します。
- 住野 秀斗, 田村 康将, 山本 雅人. “Rectified Flow に基づく残差補正を用いた歌声合成モデルの品質改善” ROBOMECH