囲碁や将棋では、盤面のすべての情報が両者に見えています。これに対してポーカーは、自分の手札は自分にしか見えず、相手の手札は相手の行動から推測するしかない「不完全情報ゲーム」です。弱い手札でも強気に賭けて相手を降ろす「ブラフ」が成り立つのは、このためです。人間どうしの交渉や競争にも通じるこうした駆け引きを AI がどう学ぶかは、人工知能の挑戦的な課題の一つです。
とくに 3 人以上で行うゲームでは、2 人のゲームで使える理論的な手法の多くがそのままでは使えません。また、相手の戦い方によって最善の振る舞いが大きく変わるため、AI が思ったほど強くならなかったときに、何が原因なのかを突き止めるのも難しくなります。
小さなポーカーで厳密に調べる
そこで私たちは、ルールを大幅に簡略化した 3 人制のポーカー(クーンポーカー)を題材にしています(図1)。カードは 1 から 5 までの 5 枚だけで、3 人に 1 枚ずつ配り、最後まで残った人の中でいちばん強い数字を持つ人が場のチップを総取りします。
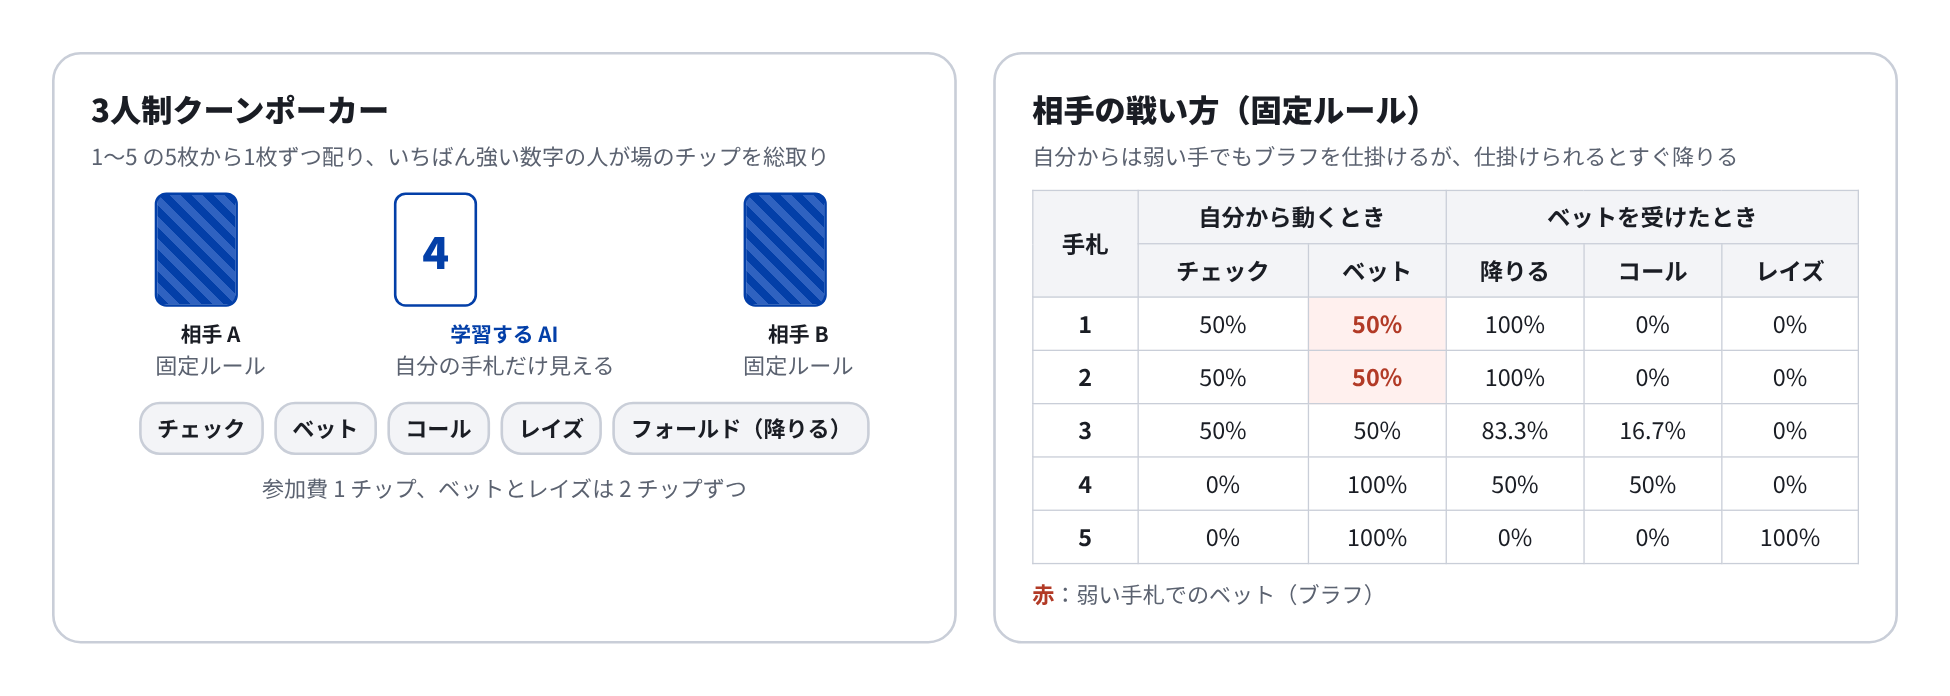
図1:題材とした 3 人制クーンポーカー(左)と、対戦相手の戦い方(右)
対戦相手の 2 人は、あらかじめ決めたルールどおりに行動します。この相手は、自分から動く場面では弱い手札でも 50% の確率でベットする(ブラフを仕掛ける)一方、ベットされると弱い手札ではほぼ必ず降ります。「自分からは緩く仕掛けるが、守りは堅い」という偏りがあり、そこにつけ込む余地があります。
ゲームが小さく、相手の戦い方も分かっているので、「この相手に対して理論上もっとも多くチップを稼げる戦い方」を、相手の手札が見えないという条件を守ったまま厳密に計算できます。その値は 1 ゲームあたり +0.294 チップでした。AI が学習した結果をこの値と比べることで、どれだけ最適に近づけたか、どの場面で損をしているかを正確に測ることができます。
相手の出方を読む AI
私たちが提案した AI は、3 つの工夫を組み合わせています。一つめは、自分・相手・卓の関係をグラフとして表現すること(グラフニューラルネットワーク)。二つめは、相手がこれまでどう賭けてきたかという履歴を、時系列のデータとして読み取ること(GRU)。三つめは、手札の強さに応じて報酬の与え方を変えることです。学習には、強化学習の代表的な手法である PPO を使いました。
結果を図2 に示します。以前の研究で作った AI は 1 ゲームあたり −0.484 チップと大きく負け越していましたが、提案手法は +0.266 チップを獲得し、理論上の最大の約 91% に到達しました。
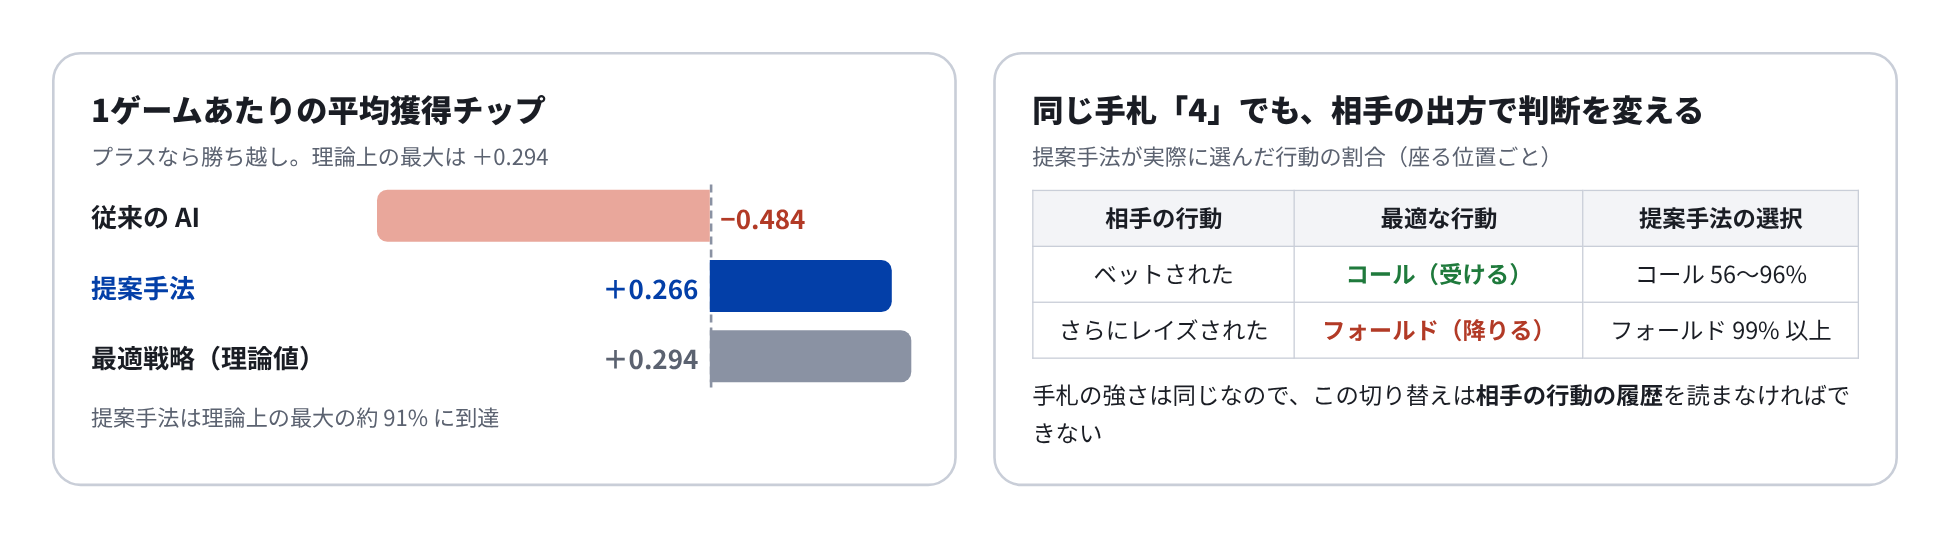
図2:獲得チップ数の比較(左)と、相手の行動に応じた判断の切り替え(右)
興味深いのは、同じ手札でも相手の出方によって判断を変えられるようになったことです。2 番目に強い手札「4」を持っているとき、相手にベットされただけなら受ける(コール)のが最適ですが、さらにレイズまでされたら降りる(フォールド)のが最適になります。提案手法はこの切り替えを再現しており、ベットされた場面では 56〜96% の確率でコールし、レイズされた場面では 99% 以上の確率で降りました。手札の強さは同じなので、相手の行動の履歴を読み取れていなければ、この使い分けはできません。
弱い手札では素直に降りることも学習しています。参加費は 1 チップ、ベットは 2 チップなので、降りれば損は 1 チップで済みますが、勝ち目のない手札で受けると 3 チップを失います。
AI はどこで損をしているのか
残る約 9% の差がどこから生じているかも調べました。この AI が判断を迫られる場面は全部で 45 通りあります。それぞれについて、最適な行動と AI の行動の違いによる損失を計算したところ、損失の 65% が手札「4」の場面に集中していました。
手札「4」は、受けるか降りるかの期待値がほぼ拮抗する、もっとも判断の難しい手札です。AI はここで、本来よりも多く降りてしまっていました(最適では 18% のところ、32%)。一方、降りるべきことが明らかな弱い手札での損失は、全体のわずか数% でした。学習中の経験が足りないせいではないことも確認しています。
このことから、不完全情報ゲームでの AI の強さは、ネットワークの構造そのものよりも、報酬の与え方や学習方法の細かな精度に左右され、とくに「どちらを選んでも差が小さい」場面でその影響が現れると考えています。
今後に向けて
最終的に目指しているのは、相手がどんな戦い方をするか事前に分からなくても、安定して勝ち越せる AI です。今後は、複数の戦い方がランダムに切り替わる相手との対戦へと環境を広げ、相手のタイプを行動から推定しながら戦い方を変えられる AI の実現に取り組みます。
- 村田 秦一郎, 田村 康将, 山本 雅人. “時系列情報の活用と報酬設計が強化学習エージェントの最適戦略からの乖離に与える影響” 情報処理学会 第59回ゲーム情報学研究会