「自分のデータを AI の学習に使わないでほしい」。EU の一般データ保護規則(GDPR)などでは、ユーザーが自分のデータの削除を求められる「忘れられる権利」が保障されています。ところが、AI が一度学習してしまったデータは、データベースから 1 行消すようには取り除けません。学習済みのモデルから特定のデータの影響だけを取り除く技術は Machine Unlearning(機械学習における「忘却」)と呼ばれ、近年さかんに研究されています。
最も確実な方法は、忘れたいデータを除いて AI を最初から学習し直すこと(Retrain)です。しかし大きなモデルでは時間も計算コストもかかり、削除要求のたびに行うのは現実的ではありません。そこで、学習し直さずにモデルの一部だけを修正して「忘れたことにする」近似的な手法が数多く提案されています。
現実に起こる2つの制約
私たちは、実際の運用で起こりうる次の2つの制約に注目しています。
一つは、忘却を行う時点で元の訓練データが手元に残っていないことです。多くの既存手法は、忘れたいデータ以外の訓練データ(保持データ)を使ってモデルの性能を保ちますが、GDPR の保存制限の原則に従うと、学習後に訓練データは速やかに消去されます。使えるのは「学習済みモデル」と「忘れたいデータ」だけ、というこの状況を Retain-Free 制約と呼んでいます。
もう一つは、忘れたいデータがごく少数であることです。削除要求は特定の個人のデータに対するものなので、対象は数枚から数百枚程度に限られます。この少数サンプル忘却(Few-Shot Forgetting)では、わずかなデータに対する修正がモデル全体に強く効きすぎて、関係のないデータまで分からなくなってしまう「過剰忘却」が起こりやすくなります(図1)。
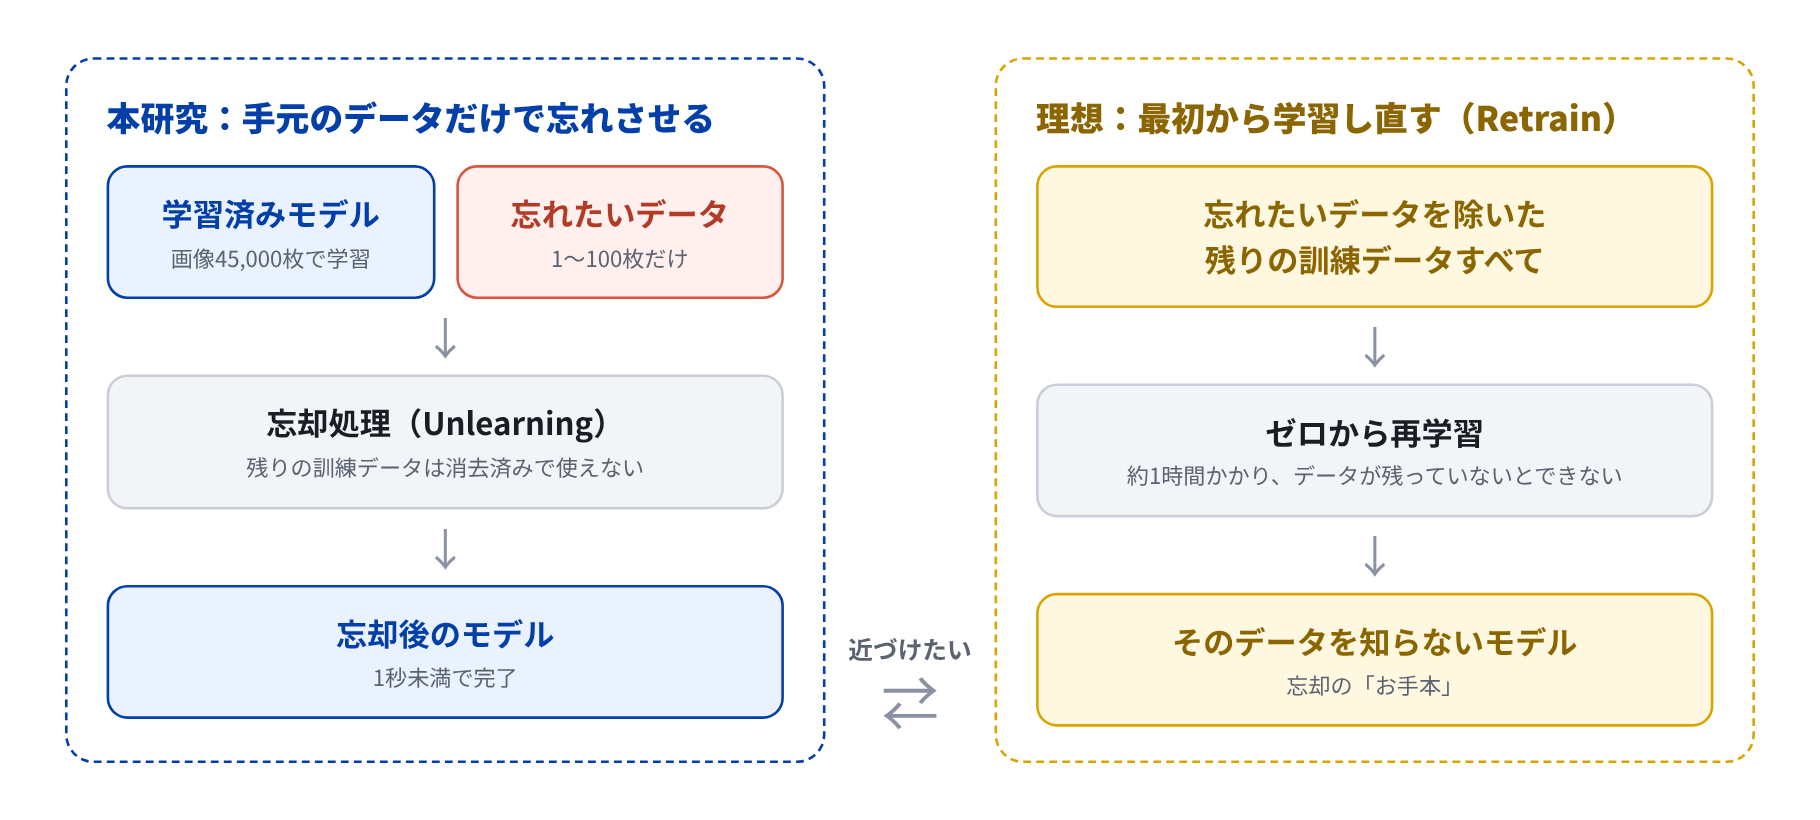
図1:本研究が対象とする問題設定。残りの訓練データを使わずに、学習し直したモデル(Retrain)に近づけることを目指す
「忘れた」とはどういうことか
AI が本当に忘れたかどうかは、メンバーシップ推論攻撃(MIA)という方法で確かめます。一般に AI は、学習に使ったデータに対しては、初めて見るデータよりも自信満々に答える傾向があります。この「自信の差」を手がかりに、あるデータが学習に使われたかどうかを言い当てようとするのが MIA です。忘却がうまくいっていれば、忘れたはずのデータに対する AI の反応は初めて見るデータと区別がつかなくなり、攻撃者は「学習に使われた」と判定できなくなります。
ここで大事なのは、忘れることと間違えることは同じではないという点です。実験では、忘れたいデータを除いて学習し直したモデルでも、少数のデータであればそのデータを正しく分類し続けました。同じクラスの他のデータと共通する特徴から、正解できてしまうためです。つまり目指すべきは、わざと間違えさせることではなく、「学習に使ったデータだからこそ」の過剰な自信だけをなくすことだといえます。
提案手法:CSK
既存の Retain-Free 手法を CIFAR-10 という画像データセットで比較したところ、その挙動は大きく2つに分かれました。モデル全体を無制約に書き換える手法(GA、RL)は、たった10枚を忘れさせるだけでテスト精度が 94% から 30% 前後まで落ちてしまいます(過剰忘却)。一方、慎重に書き換える手法(IMU、NPO)は精度をある程度保つものの、忘れたはずのデータが「学習に使われた」と見抜かれたままでした(忘却不足)。
そこで私たちは、最も単純な手法である Gradient Ascent(GA)に2つの簡単な変更を加えた CSK(Confidence-Suppressing Knowledge distillation)を提案しました(図2)。
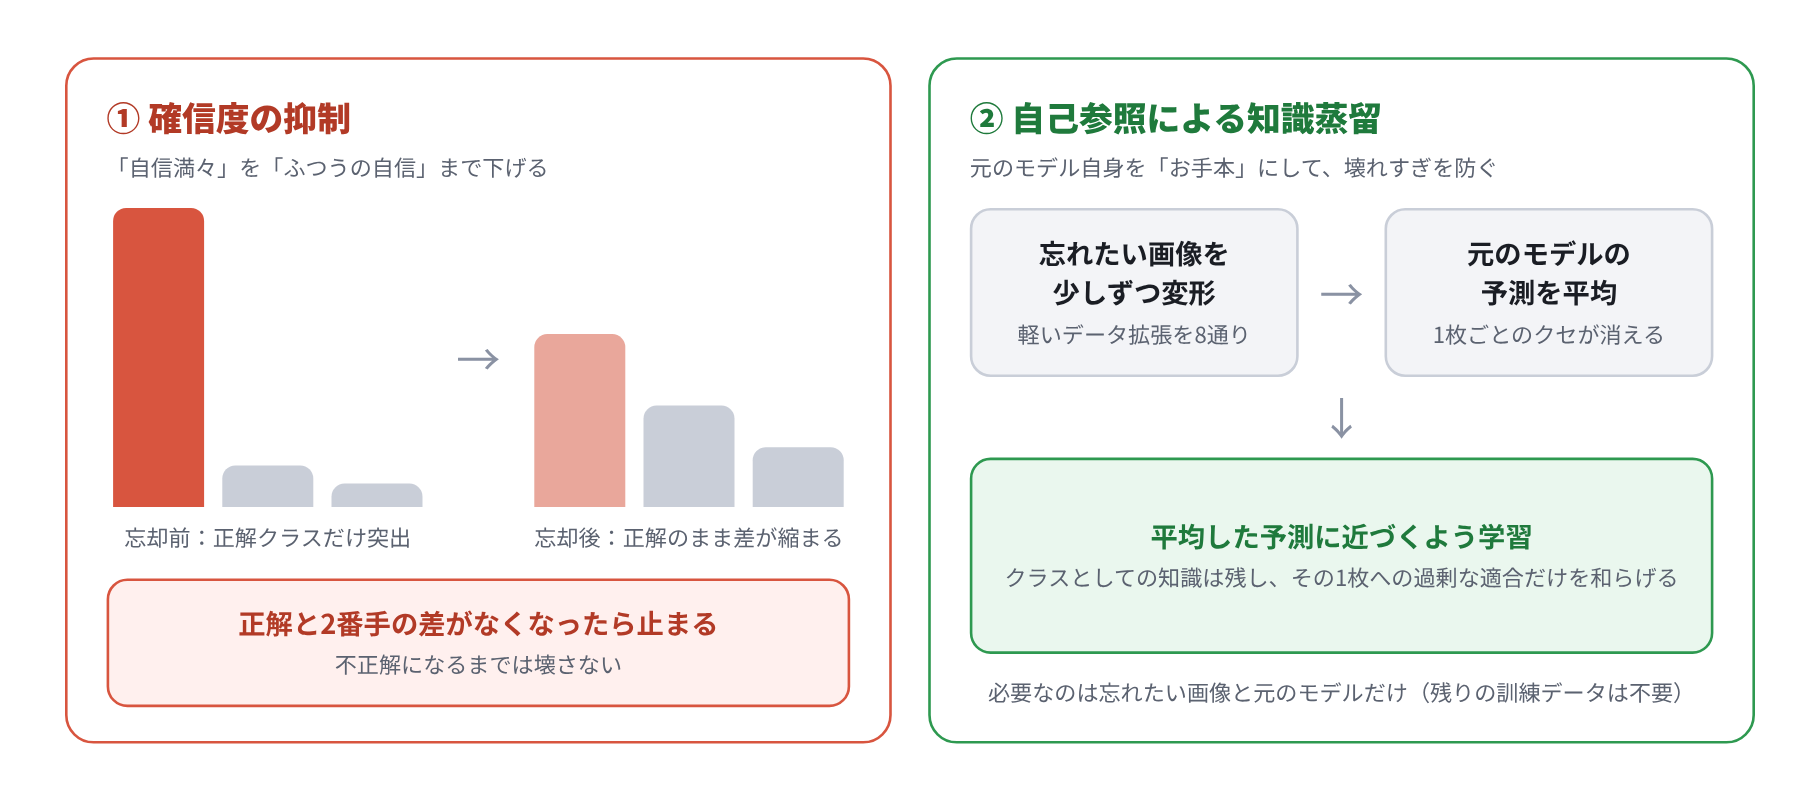
図2:CSK の2つの工夫
一つめは確信度の抑制です。忘れたいデータに対して、正解クラスと2番手のクラスとの差(マージン)を小さくするように学習します。もとの GA は、AI が自信をもって正解しているデータほど修正の信号が弱くなるという弱点がありましたが、この方法では自信の強いデータにも一定の強さで修正がかかります。さらに、差がなくなった時点で修正が自動的に止まるので、必要以上に壊してしまうことがありません。
二つめは自己参照による知識蒸留です。忘れたい画像に軽い変形を加えたものを8通り用意し、元のモデルの予測を平均したものを「お手本」にします。平均をとることで、その1枚に対する過剰な適合は薄まり、クラスとしての一般的な知識だけが残ります。このお手本から離れすぎないように学習することで、性能の低下を防ぎます。必要なのは忘れたい画像と元のモデルだけなので、残りの訓練データは使いません。
加えて、書き換えるのはモデルの最終層だけに限定しています。
実験結果
画像45,000枚で学習した ResNet-18 から、飛行機クラスの画像を 1 枚、10 枚、100 枚忘れさせる実験を行いました。10枚の場合の結果を表1に示します。
| 手法 | テスト精度 (%) | 忘却データの正解率 (%) | MIA | 処理時間 (秒) |
|---|---|---|---|---|
| 忘却前のモデル | 94.66 | 100.0 | 0.00 | — |
| Retrain(学習し直し) | 94.52 | 100.0 | 0.20 | 3658 |
| IMU | 91.60 | 80.0 | 0.30 | 0.2 |
| GA | 35.51 | 0.0 | 1.00 | 0.3 |
| RL | 28.37 | 30.0 | 0.70 | 0.2 |
| NPO | 83.27 | 60.0 | 0.40 | 0.3 |
| CSK(提案手法) | 93.93 | 100.0 | 0.60 | 0.3 |
表1:10枚の画像を忘れさせたときの比較。MIA は忘却データが「学習に使われていない」と判定された割合で、大きいほど忘却が進んでいることを表す
CSK は、テスト精度を 92〜94%、忘却データの正解率を 98〜100% と学習し直したモデルと同じ水準に保ったまま、MIA を 1 枚で 1.00、10 枚で 0.60、100 枚で 0.57 まで高めました。つまり、正しく分類する力は残したまま、「学習に使われた」という痕跡だけを小さくできています。処理時間は 1 秒未満で、学習し直す場合(約1時間)と比べてはるかに短時間です。今回の実験では、性能を保ちながら忘却を達成できた Retain-Free 手法は CSK だけでした。
一方で、10 枚以上を忘れさせる場合、CSK の MIA は学習し直したモデルの値(0.20、0.09)を上回っており、お手本よりも強く忘れすぎている状態です。プライバシー保護の面では安全側ですが、学習し直したモデルに一致させるという目標からは行きすぎといえます。
今後に向けて
今後は、「自信の強さを、初めて見るデータと同じ水準に合わせる」という考え方を軸に、忘却の強さを学習し直したモデルに自動的に合わせる仕組みや、最終層以外も含めた更新、複数の指標を組み合わせた評価に取り組みます。また、より難しいデータセットや、さまざまなクラス・データに対する削除要求にも対応できる、実用的な忘却手法の確立を目指しています。
- 保延 荘志, 田村 康将, 山本 雅人. “少数サンプル忘却における Retain-Free Machine Unlearning 手法の特性評価と改良” FIT2026