動画を見て、映っている人が何の行動をしているか分類する問題は行動認識と呼ばれます。行動認識は機械学習における基本的な問題であり、動画検索技術などへの応用が期待できます。近年、深層学習の著しい発展に伴って行動認識の性能は大きく向上しましたが、深層学習は学習に大量の教師付きデータ(正解)を要するという課題があります。教師付きデータとは動画とその動画に映っている人が何の行動をしているかというラベルのペアのことですが、当然ラベルは人間が付けていく必要があるため教師付きデータを作るには高いコストがかかります。私たちは、この課題を解決するために、教師付きデータと教師なしデータの両方を利用することで、ほとんど教えない深層学習を行う手法をについて研究しています。専門的には、半教師あり学習と呼びます。ここては、私たちが提案した手法[1]について紹介します。
私たちが提案した手法は、Pseudo Label(擬似ラベル)と呼ばれる手法をベースとしています(図1)。ここでは詳しく説明することはしませんが、簡単に言えば教師なしデータのラベルを一度予測して、もしその時の予測ラベルの確信度が十分高ければそのラベルが合っていると仮定し、教師なしデータと予測ラベルのペアを教師付きデータとして使いましょう、という手法です。
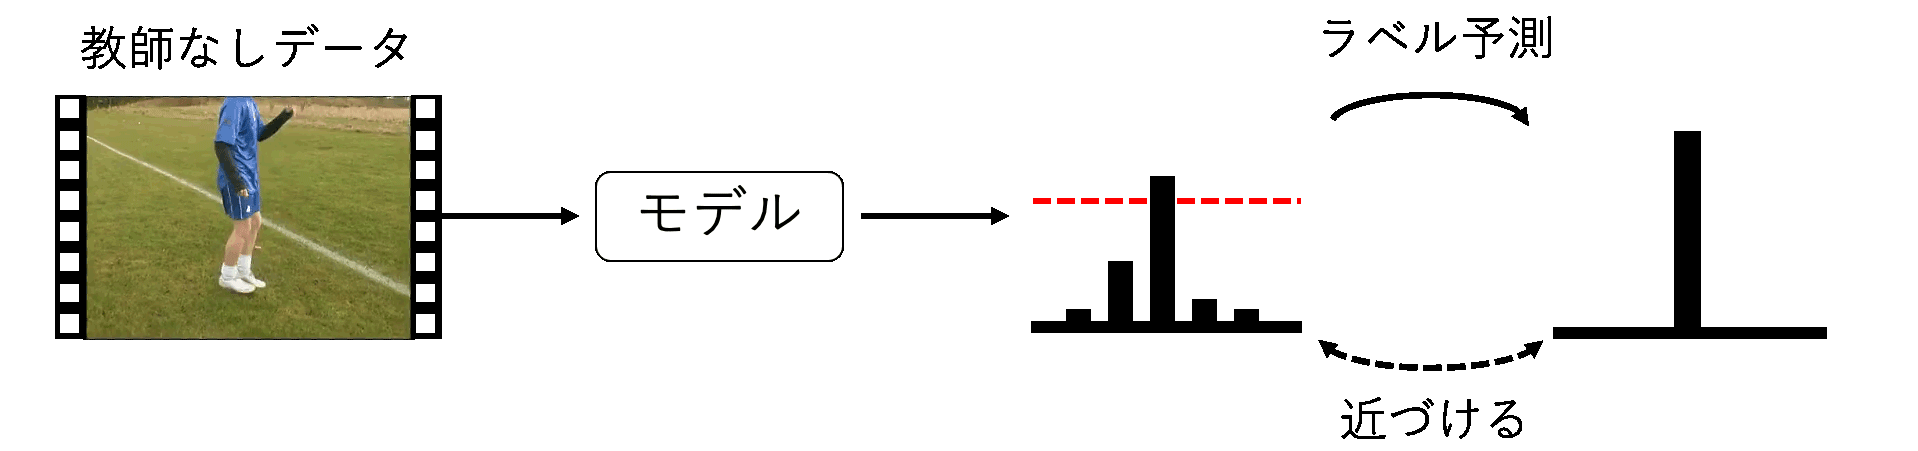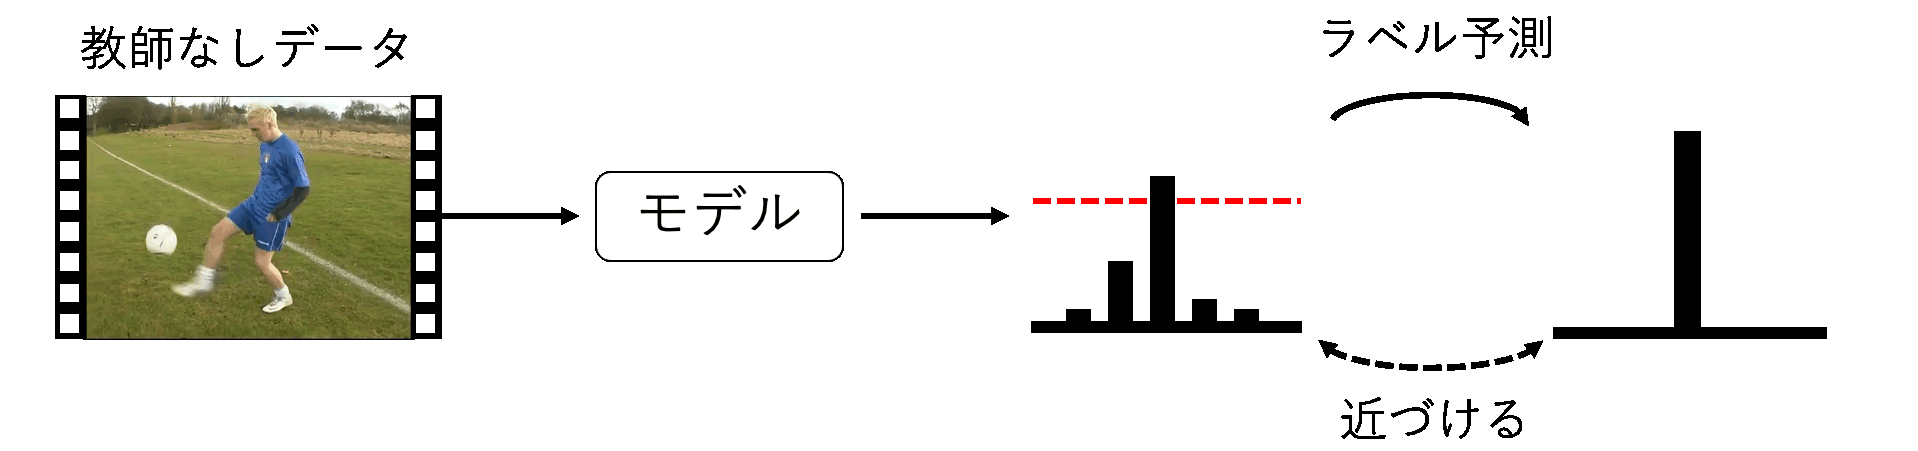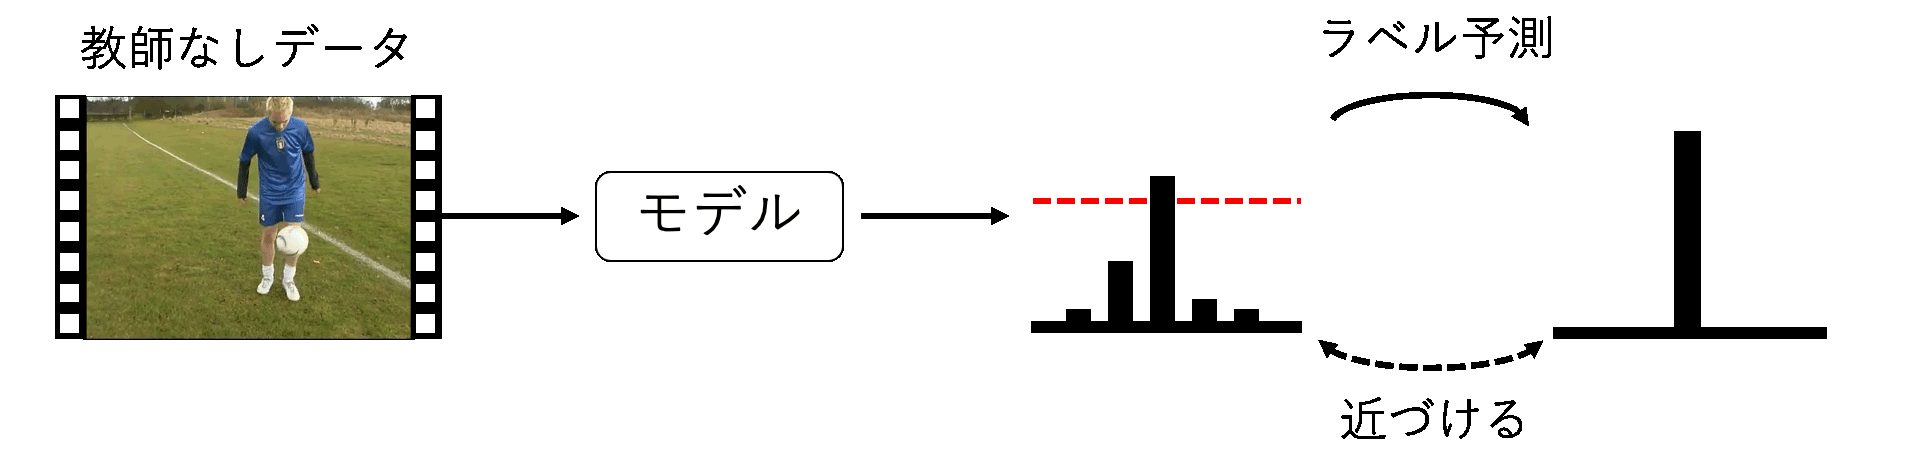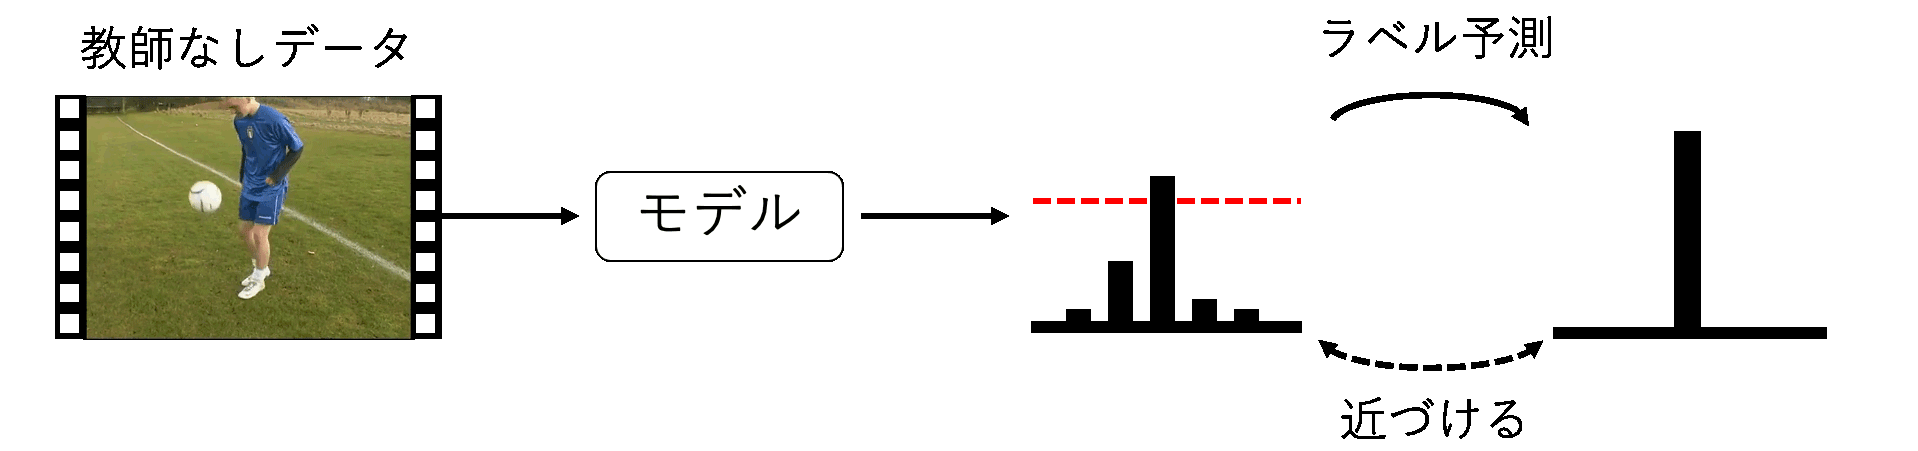
図1。Paeuedo Label(擬似ラベル)の概念図
実は、Pseudo Labelを使って行動認識を学習してもあまりよい精度が出ないことが先行研究によって示されていました。私たちはこの原因として、動画データに含まれる無数の情報の重複にあると考えました。動画は、画像の時系列データですが隣り合った画像間ではほとんど差がありません。(パラパラ漫画を思い浮かべると分かりやすいかもしれません。)つまり、ほとんどの情報が重複しているのですが、この重複が行動認識をする上で無駄な情報であることは明らかです。そのため、動画をそのままモデルに入力するのではなく、一度動画を圧縮し、そこから得られる重複が削減された情報をモデルに入力するほうが、行動認識をする上で有益な情報に注目させやすくすることができ、それが精度向上に繋がると考えました。
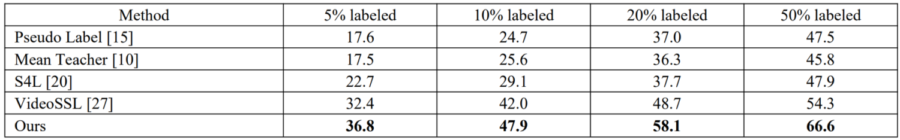
そこで、私たちは動画を圧縮して得られる情報を入力としてPseudo Labelの学習をおこなう手法を提案しました。実際に、行動認識のベンチマークのひとつであるUCF101というデータセットで半教師あり学習をした場合、ほかの手法と比較して提案手法は高い精度を達成できることを示しました。(表1)
表1。UCF101における提案手法と先行研究との比較。データセット全体に占める教師付きデータの比率を変えて学習し、その分類精度を比較した。
1.Hayato Terao, Wataru Noguchi, Hiroyuki Iizuka, and Masahito Yamamoto. “Semi-supervised learning combining 2DCNNs and video compression for action recognition.” ICVISP 2020